Mostrando entradas con la etiqueta SQL Server 2008. Mostrar todas las entradas

viernes, 8 de julio de 2011

Nuevo artículo en la web MSDN de SQL Server publicado

Me complace de nuevo anunciar que me han publicado un nuevo artículo en la web de microsoft MSDN oficial para SQL Server. En esta ocasión la temática es Log Shipping y como personalizarlo hasta un nivel mas allá de lo “predeterminado”.

Introducción al artículo:

“El hecho de que Log Shipping sea una de las tecnologías que antes vinieron de la mano con las primeras versiones de SQL Server, no quita que sea siendo muy válido en una gran cantidad de soluciones a problemas reales de la actualidad. Pero log Shipping tiene un requerimiento que lo limita de entrada a funcionar en un entorno gestionado bajo un único Active Directory (o al menos entre varios AD, pero con confiabilidad). En este artículo vamos a ver cómo podemos personalizar un entorno en el que sin disponer de confiabilidad entre varios AD, podamos hacer funcionar Log Shipping.

Log Shipping consiste en automatizar ….”

Para continuar leyendo: http://msdn.microsoft.com/es-es/sqlserver/hh291511

viernes, 18 de febrero de 2011

Aprovecha las características TVP y MERGE en tus aplicaciones

Introducción

La versión de SQL Server 2008 trajo consigo muchísimas novedades. De entre todas las que podríamos considerar enfocadas al desarrollo, he creído interesante hablar de dos de ellas, que combinadas consiguen un resultado bastante más que interesante en la mayoría de situaciones. En este artículo, veremos como plantear una solución óptima de modificación de datos utilizando las características “TVP” (parámetros de tabla) y la sentencia MERGE. Cada una de las dos, por si solas son interesantes para proporcionar solución a determinados problemas, pero juntas nos dan la posibilidad de escribir un código que además de sencillo y limpio, es realmente eficiente desde el punto de vista de la escalabilidad.
…El artículo continua aqui.

viernes, 22 de octubre de 2010

Ejecución de paquetes SSIS por código

En todo proyecto, puede surgir la necesidad de lanzar paquetes SSIS al vuelo mediante .NET. Este post está centrado en mostrar una forma de hacerlo utilizando las librerias de administración de SSIS y en dar una idea de al menos, como podeis empezar.

Ejecutar manualmente

Recordemos que para lanzar un paquete SSIS podeis utilizar el SQL Server Management Studio de la siguiente forma:

1. Conectar al servidor de SSIS (por ejemplo yo-pc\sql2008r2):

image

NOTA: No es posible utilizar las herramientas de SQL Server Express para conectar a Integration Services, hay que utilizar la versión Developer o Enterprise

2. Ir a Stored Packages->MSDB->DTS (la carpeta DTS ha sido creada manualmente por mi para el ejemplo)

image

3. Con botón derecho en el paquete SSIS a ejecutar, si lanzar “Run Package”:

image

Este es el formulario de ejecución donde poder dar valor a variables. Para terminar ejecutando, click en “execute”.

image

Por código Visual Basic.NET

El proposito de la entrada de este post es ejecutar código mediante código .NET. Para ello existen dos opciones para realizar ejecuciones de paquetes SSIS mediante código, la primera consiste en utilizar las clases de la librería Microsoft.SqlServer.ManagedDTS.dll y la otra utilizar la aplicación enominada dtexec que viene con las herramientas de inteligencia de negocio de SQL Server.

En ambos casos, hay que instalar como mínimo las herramientas cliente de inteligencia de negocio como vemos en la imagen (no es necesario instalar ningun sevicio de SQL Server en los clientes por tanto, ni las herramientas de administración):

image

NOTA: La imagen corresponde a instalación de SQL Server express con herramientas avanzadas

Para obtener tanto la herramienta, como las dll, en este caso si que nos vale por tanto utilizar la versión express con herramientas cliente avanzadas: http://www.microsoft.com/downloads/details.aspx?familyid=B5D1B8C3-FDA5-4508-B0D0-1311D670E336&displaylang=es


Ejecución mediante código Visual Basic

Una vez tenemos las librerías instaladas en el equipo desde donde queramos lanzar los paquetes SSIS, podemos utilizar código como el siguiente para efectuar ejecuciones de los mismos:

A continuación vemos como sería el código en Visual Basic.NET para ejecutar un Paquete SSIS.

NOTA: Si la aplicación no es .NET (por ejemplo, si es VB6) hay que programar un wrapper de acceso a la libreria ManagedDTS mencionada anteriormente (el código de más abajo es VB.NET). Más adelante, se da opción de utilizar dtexec, si no se quiere implementar dicho wrapper

Los paquetes deben estar desplegados en el servicio de Integration Services y además según se puede ver en el ejemplo de código, haberse desplegado sobre la carpeta DTS (no es requisito, pero para el ejemplo se ha realizado de esta forma, para ir alineados con las imágenes anteriores también).

Imports DTS = Microsoft.SqlServer.Dts.Runtime
Module Module1
    Sub Main()
        Dim instance As DTS.Application
        Dim packagePath As String
        Dim serverName As String
        Dim serverUserName As String
        Dim serverPassword As String
        Dim events As DTS.IDTSEvents
        Dim returnValue As DTS.Package
        Dim executionResult As DTS.DTSExecResult
        instance = New DTS.Application()
        packagePath = "\DTS\__TuDTSVaAqui__"


        serverName = "__TuServidorVaAqui__"
        serverUserName = "solidq" 'Nombre de usuario
        serverPassword = "solidq" 'Password de usuario
        events = Nothing
        returnValue = instance.LoadFromSqlServer(packagePath, serverName, serverUserName, serverPassword, Nothing)
 ‘Para asignar propiedades a variables
  ‘pkg.Variables("VarName").Value = "Value"
        executionResult = returnValue.Execute()
        If executionResult = DTS.DTSExecResult.Success Then
            Console.WriteLine("Paquete ejecutado correctamente")
        Else
            If executionResult = DTS.DTSExecResult.Failure Then
                Console.WriteLine("Se produjo un error al ejecutar el paquete")
            End If
        End If
        Console.ReadKey()
    End Sub
End Module

NOTA: El usuario que ejecute debe tener permisos en la Base de datos MSDB, puesto que es necesario listar las carpetas acceder a la carpeta DTS y cargar el paquete.

 
Ejecución mediante línea de commandos dtexec

Este método es el más sencillo y consiste en lanzar el paquete utilizando la aplicación dtexec, destinada especialment para ello.


Se parte de la base nuevamente en que se ha instalado la herramienta en el cliente y por tanto se encuentra instalada y accessible (por defecto se encuentra en C:\Program Files\Microsoft SQL Server\100\DTS\Binn\)

Se trataria por tanto de realizar una llamada desde visual basic a la aplicación dtexec con los parámetros necesarios (ver imagen adjunta como ejemplo sencillo):


image


Por ejemplo, para lanzar el paquete llamado “paquetePrueba” que se encuentra en el servidor “yo-pc\sql2008r2”, utilizando un usuario de sql “usuariosql” y password “passwordusuario”, asignando valor a la variable llamada “miVariable”, podríamos crear una llamada como esta:

Dtexec /ser yo-pc\sql2008r2 /U usuariosql /P passwordusuario /sq paquetePrueba /set \package.variable[miVariable].Value;AquiPonesElValorQueQuieresAsignar


NOTA: Para información sobre los parámetros de entrada podemos utiliza dtexec /? O diréctamente dirigirnos a la web de consulta de dtexec aqui: http://technet.microsoft.com/en-us/library/ms162810(SQL.100).aspx

Que lo disfruteis.

martes, 27 de julio de 2010

Restaurar multiples bases de datos a la vez

En ocasiones hace falta realizar restauraciones masivas de ficheros de backup. Situaciones como resolver una catástrofe o realizar pruebas de migración, pueden requerirnos restaurar 40, 100 bases de datos…y aqui es donde entra este script.

Para el proyecto en el que estoy ahora involucrado, estoy realizando pruebas que involucran directamente restauraciones de más de 50 BBDD y claro…los informáticos no nos caracterizamos por nuesta pasión a las tareas repetitivas, asique…¿mejor que lo haga otro, no?. Pues bien, ese otro será nuestro SQL Server Smile

Los parámetros de inicio del siguiente script son:

  1. dbs: Cursor con los nombres de ficheros de backup a restaurar (si se llama mibbdd.bak, pues mibbdd)
  2. pathFisicoMDF: Ruta donde acabarán los ficheros de datos
  3. pathFIsicoLDF: Ruta donde acabarán los ficheros de log
  4. pathToBak: Ruta donde buscar los ficheros de backup .bak

Solo una cosa mas,

/*
Enrique Catala Bañuls
*/
declare @path nvarchar(max)
DECLARE @dbName sysname
DECLARE @logicalName sysname
declare @physicalName nvarchar(max)
declare @fileName nvarchar(max)
declare @sSql nvarchar(max)
declare @fileType char(1)
declare @pathToBak nvarchar(max)
declare @pathFisicoMDF nvarchar(max)
declare @pathFisicoLDF nvarchar(max)

/*********************************************************************************************/
/*********************************************************************************************/
--
-- FILL HERE DATA NEEDED TO THE RESTORNG PROCESS
--
DECLARE dbs CURSOR READ_ONLY
-- bases de datos restaurándose
FOR select 'bdeap'


select @pathFisicoMDF = N'e:\datos\',
@pathFisicoLDF = N'd:\logs\',
@pathToBak = 'E:\fulldiaria\'
/*********************************************************************************************/
/*********************************************************************************************/

create table #tmp
(
LogicalName sysname
,PhysicalName nvarchar(max)
,Type char(1)
,FileGroupName sysname NULL
,Size numeric(20,0)
,MaxSize numeric(20,0),
Fileid tinyint,
CreateLSN numeric(25,0),
DropLSN numeric(25, 0),
UniqueID uniqueidentifier,
ReadOnlyLSN numeric(25,0) NULL,
ReadWriteLSN numeric(25,0) NULL,
BackupSizeInBytes bigint,
SourceBlocSize int,
FileGroupId int,
LogGroupGUID uniqueidentifier NULL,
DifferentialBaseLSN numeric(25,0) NULL,
DifferentialBaseGUID uniqueidentifier,
IsReadOnly bit,
IsPresent bit,
TDEthumbprint varbinary(32) NULL
)

OPEN dbs
FETCH NEXT FROM dbs INTO @dbName
WHILE (@@fetch_status <> -1)
BEGIN
IF (@@fetch_status <> -2)
BEGIN

SELECT @sSql = '',
@path = 'restore filelistonly from disk = N'''+@pathToBak+@dbName+'.bak'''

--PRINT @path

insert #tmp
EXEC (@path)

--select * from #tmp

DECLARE dbs2 CURSOR READ_ONLY
FOR select logicalName,physicalName,type from #tmp
OPEN dbs2

FETCH NEXT FROM dbs2 INTO @logicalName,@physicalName,@fileType
WHILE (@@fetch_status <> -1)
BEGIN
IF (@@fetch_status <> -2)
BEGIN
set @fileName= substring(@physicalName,
2+len(@physicalName)-charindex('\',reverse(@physicalName)),
charindex('\',reverse(@physicalName)))

if @fileType = 'D'
set @sSql = @sSql+' MOVE N'''+@logicalName+''' TO N'''+@pathFisicoMDF+@fileName+''','
else
set @sSql = @sSql + ' MOVE N'''+@logicalName+''' TO N'''+@pathFisicoLDF+@fileName+''','

--print @logicalName
--print @pathFisicoMDF
--print @sSql

END
FETCH NEXT FROM dbs2 INTO @logicalName,@physicalName,@fileType
END

CLOSE dbs2
DEALLOCATE dbs2

--print @dbName
--print @pathToBak
--print @sSql
--SET @sSql = 'RESTORE DATABASE ['+@dbName+'] FROM DISK = N'''+ @pathToBak +'\' +@dbName + '.bak''
SET @sSql = '
RESTORE DATABASE ['+@dbName+'] FROM DISK = N'''+ @pathToBak +'\' +@dbName + '.bak''
WITH FILE = 1, '
+@sSql+
'
RECOVERY, NOUNLOAD, REPLACE, STATS = 10'
--print @sSql
exec(@sSql)

truncate table #tmp
END
FETCH NEXT FROM dbs INTO @dbName
END

CLOSE dbs
DEALLOCATE dbs
GO
drop table #tmp


martes, 6 de julio de 2010

Averiguar conexiones externas hacia nuestro SQL Server

Últimamente estoy participando en bastantes proyectos de migración de SQL Server 2000 a SQL Server 2008 R2. Independientemente de la arquitectura existente en cada cliente, siempre hemos de conocer la topologia de consultas que se lanzan y sobre todo QUIEN las lanza.

En un proyecto de migración nunca podemos dejar cabos sueltos y menos cuando uno de los cabos sueltos puede llevar a que aplicaciones (sean o no críticas) no funcionen.

La opción más sensata siempre es crear una traza de profiler para SQL Server 2000, que nos capture durante un tiempo prudencialmente amplio y significativo, la actividad de nuestro servidor

¿Qué nos interesa conocer?

  1. La consulta que ha sido lanzada (posteriormente lo utilizaremos para que SSUA analice si hay patrones conflictivos)
  2. El hostname desde donde se lanza
  3. El login utilizado
  4. El nombre de la aplicación
  5. La BBDD sobre la que se está ejecutando la consulta


Dicho esto, nos podemos hacer una idea de los eventos e información que necesitamos capturar en SQL Server profiler…y ahora viene la parte divertida…la explotación de esos datos Smile

-- Create table with data
--
CREATE TABLE [dbo].ExternalConnectionAnalysis(
[ServerName] [nvarchar](256) NOT NULL,
[databaseid] [int] NULL,
[applicationname] [nvarchar](256) NULL,
[hostname] [nvarchar](256) NULL,
[loginname] [nvarchar](256) NULL,
queries_executed bigint not null
) ON [PRIMARY]

GO

INSERT into dbo.ExternalConnectionAnalysis(ServerName, databaseid,
          applicationname, hostname, loginname,queries_executed)
SELECT 'atlante3' AS ServerName , databaseid, applicationname,
       hostname, loginname,COUNT(*)
FROM ::fn_trace_gettable('path_to_file.trc', default)
GROUP BY databaseid, applicationname, hostname, loginname
go


Tenemos esa opción que evidentemente te lee el fichero de traza .trc (y los que vengan detrás en caso de haberse creado con multiples ficheros) y agrupa por la información que queremos, o podemos optar por una forma algo más rebuscada y eficiente para procesar los datos como esta otra:


declare @srvname sysname = 'my_server'
declare @trcpath varchar(max) = 'path_to_file.trc'
;

with existent_data as(
select ServerName, databaseid,
applicationname,hostname,loginname
from dbo.ExternalConnectionAnalisys
where ServerName = @srvname
),
trc as (
SELECT @srvname AS ServerName
, trc.databaseid, trc.applicationname,
trc.hostname, trc.loginname
FROM ::fn_trace_gettable(@trcpath, default) trc
)
INSERT into dbo.ExternalConnectionAnalysis(ServerName, databaseid,
applicationname, hostname, loginname,queries_executed)
SELECT @srvname AS ServerName , trc.databaseid, trc.applicationname,
trc.hostname, trc.loginname ,COUNT(*)
FROM trc left join existent_data ed on
(trc.DatabaseID = ed.databaseid
and trc.ApplicationName = ed.applicationname
and trc.HostName = ed.hostname
and trc.LoginName = ed.loginname
)
where ed.databaseid is null or ed.applicationname is null or
ed.hostname is null or ed.loginname is null
GROUP BY trc.databaseid, trc.applicationname, trc.hostname, trc.loginname


La gran ventaja de utilizar la consulta anterior radica principalmente en que es una consulta que solo añadirá las nuevas filas con información que le vayamos proponiendo. Es decir, que como es normal, tendremos ficheros de traza a traves del tiempo (cada dia previsiblemente tendremos .trc nuevos) y los podremos procesar independiemente de tener todos los ficheros de traza y procesarlos de golpe.


Evidentemente es una gran ventaja…pero otra ventaja oculta es si miras un poco más alla de la simple consulta y te das cuenta de que al utilizar el left join y el group by, nuestro SQL Server ha generado un plan de ejecución eficiente mediante un fantástico MERGE JOIN


image


Queda a tu disposición probar la consulta sin el left join, mediante un cruce de los de toda la vida y ver que ocurre…y sobre todo el tiempo que tarda, por culpa del super LOOP JOIN que te mete Smile


Salu2!

martes, 26 de enero de 2010

Nuevo ebook sobre migración de SQL Server 2000 a SQL Server 2008

Recientemente publicaron mi ebook sobre como afrontar con éxito una migración desde SQL Server 2000 a SQL Server 2008 con éxito y sin sorpresas desagradables.
Se puede encontrar aqui: http://www.solidq.com/ib/Press.aspx

"El proceso de migración hacia SQL Server 2008 no debería ser un proceso traumático. Para conseguirlo, hay que consensuar un plan lo suficientemente robusto y estable como para satisfacer todas las posibles particularidades del entorno que desee migrar en cuestión. Hay que ser consciente que como en cualquier proceso de riesgo, si es llevado a cabo negligentemente puede producir un resultado final lleno de errores e incompatibilidades de última hora que produzcan una migración traumática al final"

ISBN: 978-84-936417-6-4

domingo, 19 de abril de 2009

Como instalar un cluster de SQL Server 2008 en Windows Server 2008 (1/2)

En un solo post tratar el tema completo quedaria muy largo por lo que es mejor dividirlo en dos. Para el primer post, hablaré de como clusterizar SQL Server 2008 sobre un entorno Windows 2k8 previamente clusterizado (cuya clusterización será la segunda entrega).

1 Instalar .NET 3.5 SP1

Es necesario disponer de .NET 3.5 sp1 antes de instalar SQL Server 2008. Como paso previo a la instalación de SQL Server, se puede planificar puesto que su instalación requiere reinicio. En cualquier caso, el propio proceso de instalación de SQL Server 2008 detecta si existe el runtime .NET 3.5 SP1 y si no es así, lo instala.

2 Instalar Windows Installer 4.5

Es necesario disponer de la version Windows installer 4.5 para poder realizar la instalación de SQL Server 2008. Puesto que el propio DVD de instalación de SQL Server ya lo posee, también se puede instalar durante el proceso de instalación. Se trata del Hotfix KB942288.

3 Instalación de SQL Server 2008 sobre Clúster de W2k8

El proceso de instalación del clúster de SQL Server 2008 requiere realizarse sobre un nodo del clúster de Windows Server 2008 previamente montado; además, al igual que en el caso de windows server 2008, se ha variado su configuración respecto a ediciones anteriores (para mejor). En este caso vamos a sacarle partido y lo que haremos es ni mas ni menos que instalar un cluster de un solo nodo de SQL 2008. Sé que parece extraño, pero esto es muy util. Hace unos meses en un cliente tuvimos un problema con las cabinas de un geocluster de windows; no viene al caso el problema pero la dicho problema no impidió que montaramos el geocluster, aunque durante un dia ese geocluster solo tenia un solo nodo ;)

3.1 Instalación del primer nodo del Clúster de SQL Server 2008

Una vez introducido el DVD de SQL Server 2008 sobre el servidor, se han de seguir los siguientes pasos:

image

image

  • Clickear sobre “Instalación”

image

  • Clickear sobre nueva instalación de SQL Server Failover cluster.

Una vez detectado que no se dispone de Windows Installer 4.5, se procede a su instalación (lo mismo ocurrirá con .NET 3.5 SP1 si no se detectara:

image

Una vez instalado, se comienza con las validaciones previas a la instalación de SQL Server

image

Una vez validados los prerrequisitos, se instalarán los ficheros necesarios para la instalación de SQL Server

image

El siguiente paso es introducir la clave de registro. Una vez introducida (que puede venir ya predefinida según la licencia), se procede a la validación del estado del cluster para su futura instalación, así como de la configuración del servidor y las necesidades del entorno necesarias para que la instalación llegue a buen puerto.

image

Como vemos en la imagen anterior, existen 3 advertencias en la instalación que nos avisan de posibles configuraciones que podrían afectar al funcionamiento de SQL Server. Las advertencias permiten continuar la instalación y hacen referencia a cosas que te recomienda revisar por simple seguridad hacia ti. Evidentemente, aqui variará los mensajes que te puedan dar en tu instalación pero independientemente de lo que sea, revísalos siempre para que no se te escape nada. Algunos mensajes que te puede dar:

  • Advertencia sobre MSDTC. Si no vamos a utilizar este servicio, este aviso puede obviarse.
  • Aviso de rendimiento en la configuración de red (si tienes TEAMING activado). Te advierte de una “posible” configuración de prioridades en las tarjetas de red, que podría ocasionar una pérdida de rendimiento de red.
  • El tercer punto hace referencia a un aviso para que recordemos abrir los puertos del firewall necesarios para poder conectar externamente al servidor de SQL Server.

Una vez revisada la configuración, si pulsamos en siguiente, continuaremos con el proceso de instalación, donde seleccionaremos únicamente el motor de SQL Server y las herramientas cliente (en este ejemplo en concreto, hay mas servicios clusterizables)

image

Seleccionaremos el nombre virtual del clúster de SQL Server y el nombre de la instancia:

image

Solo habilitamos el modo de autentificación Windows para reducir la superficie de ataque, y agregamos un usuario específico o un grupo de usuarios del dominio como administradores de SQL Server.

image

Seleccionamos las rutas que queremos por defecto:

image

Configuraremos FILESTREAM si es necesario:

image

Por último ya solo falta que comience el proceso de instalación:

image

Una vez finalizada la instalación de SQL Server en el cluster, dispondremos de un cluster de SQL Server 2008 en un solo nodo.

Si abrimos el “Failover Cluster Administration”, podremos ver el estado actual de configuración de nuestro clúster.

image

Comprobamos que podemos acceder abriendo la consola de administración “SQL server Management Studio” y comprobando la versión de SQL Server (por ejemplo):

image

3.2 Adición de un nuevo nodo al clúster de SQL Server 2008

Llegados a este punto, ya tenemos montado el cluster de SQL Server, con la única salvedad de que es un cluster de un solo nodo (pero eso si, funcional). El siguiente paso evidentemente es recomendable porque cuando montamos un cluster, no lo hacemos en principio para tener un único nodo…en cualquier caso, ya sabeis que se puede trabajar con SQL Server en este momento y posteriormente cuando se pueda, configurar este paso tantas veces como nodos queramos tener.

Para ello, introduciremos el DVD de SQL server en el servidor que vamos a añadir al cluster de SQL 2008

image

NOTA: No insertar en el nodo ACTIVO

En este caso, lo que haremos será clickear sobre la opción de añadir un Nuevo nodo a un clúster existente.

image

De nuevo se realizan procesos de validación en este nodo, para detector inconsistencias. En este caso de nuevo aparecen advertencias. Pese a que puedan ser las mismas que antes, debemos comprobar que todo es correcto

image

Una vez detectado el clúster donde hemos de ingresar este nodo, lo que haremos será configurar las cuentas de servicio reintroduciendo los passwords de nuevo en el caso de nuestros inicios de sesión de base de datos y SQL Server Agent.

El resto del proceso son formularios donde nuestra única aportación será la de clickear en “siguiente” tras validar la información

image

image

Por último ya solo queda probar un failover si queremos comprobar que todo va a ir como toca y listo, a trabajar! ;)

domingo, 5 de abril de 2009

¿Por qué migrar a SQL Server 2008?

Una pregunta que últimamente se da con frecuencia es la de: “vale, pero yo tengo mi sistema con SQL 2000 y me va bien ¿que gano yo instalándome el SQL 2008 si no voy a utilizar ninguna de sus novedades a priori?”. Para este tipo de cuestiones, evidentemente uno se puede poner a enumerar una por una todas y cada una de las novedades que aparecen en SQL Server 2008, pero eso no le resolverá la duda a la persona que la plantea, sino que probablemente piense que tiene un montón de “extras” que no le sirven para nada (datos espaciales, jerárquicos,…).

Es por ello, que en este post voy a poner algunas de las razones que a mi modo de ver, son las mejoras mas significativas que se nos ofrecen, por el simple y mero hecho de instalar SQL Server 2008 y restaurar ahí nuestra BBDD de SQL 2000:

  • Compresión de datos

Como sabemos, en SQL Server 2008 disponemos de la posibilidad de realizar compresión de datos. En algunos posts anteriores (este y este) , ya discutí las bondades de disponer de esta característica. Ciertamente, el disponer de entrada, de la posibilidad de comprimir datos o backups, es algo muy a tener en cuenta. Es más, todavía me falta el post III de III, donde se podrán ver las grandes mejoras en cuanto a rendimiento se refiere, de activar la compresión de datos.

image

  • Resource Governor

Gracias a Resource Governor, vamos a poder conseguir que el motor relacional se comporte como queremos. Se acabaron las consultas que nos tumban el servidor, aquellos reports que lanzaba el director cuando le apetecía una y otra vez que nos ralentizaban a todos, esas consultas críticas que no salían cuando se las necesitaba porque el becario estaba jugueteando con eso llamado T-SQL en producción,…

image

  • Consolidación de servidores

Gracias a la característica de “administración centralizada de servidores” (Central Management Servers), podremos gestionar múltiples servidores de forma simultanea. Desde el mismo momento en que instalemos SQL Server 2008, podremos gestionar SQL 2008, SQL 2005 e incluso SQL 2000 de una manera centralizada, validando políticas de seguridad, lanzando comandos T-SQL de administración,…Es decir, que por el mero hecho de tener un único SQL 2008, nos vamos a beneficiar incluso en la gestión de servidores de otras ediciones.

image

  • Transparent Data Encryption

¿Te has parado a pensar en qué ocurre si un backup de producción cae en malas manos? Quizás estás pensando que realmente no pasa nada porque tu ya estás implementando encriptación a nivel de columna mediante certificados en SQL Server 2005…; ¿y si te dijera que con solo lanzar un comando, SQL Server 2008 cifra TODO y además de forma transparente a tus aplicaciones? Pues es posible y se llama TDE (Encriptación transparente de datos), una característica por la que incluso los propios backups realizados sobre una BBDD cifrada mediante TDE son imposibles de restaurar sin su certificado y/o password, y están completamente cifrados.

  • Consultas mas eficientes para tipos de datos fecha

Con la aparición de los nuevos tipos de datos fecha, aparece el tipo de datos “date”. Gracias a el, cuando deseemos realizar una consulta a un datetime o smalldatetime para obtener datos filtrados por una fecha en particular, podremos realizar una consulta mas natural y eficiente de la siguiente forma:

select * from dbo.TestIndexSeek where cast(sample_datetime as date) = '20071208';

*NOTA: sample_datetime puede ser de tipo datetime o smalldatetime, no es necesario que cambiemos nada en nuestro modelo EER


Este tipo de consultas, pese a lo que se pueda pensar al ver el cast al lado izquierdo de la comparación, ahora son eficientes (se entiende que existe un índice sobre sample_datetime).

image

  • Múltiples hilos para consultas sobre datos particionados

En SQL Server 2005, si una consulta debía recorrer múltiples particiones para devolver los resultados, solo existía un único hilo para recorrerlas. En SQL Server 2008, mejoras en el motor relacional hacen que existan múltiples hilos no solo para recorrer cada partición, sino para aquellas operaciones que deben moverse entre particiones para devolver datos

image

  • Indexación eficiente mediante filtrado de índices

Ahora es posible definir índices filtrados. Si conocemos que existen consultas que filtran datos sobre columnas cuya distribución de datos solo hace posible la utilización del índice en escasos predicados, podemos hacer un índice filtrado que optimice dichas consultas únicamente. Con ello obtendremos un índice mas ligero, puesto que solo será mantenido para el predicado que le hayamos dicho nosotros

CREATE NONCLUSTERED INDEX idx_territory5_orderdate
ON Sales.SalesOrderHeader(OrderDate)
INCLUDE(SalesOrderID, CustomerID, TotalDue)
WHERE TerritoryID = 5;
  • Seguimiento de cambios y de datos y mejoras en auditoria

En SQL Server 2008 existen las características CDC (Change Data Capture) y CT (Change Tracking) mediante las cuales podemos realizar un seguimiento de cambios de nuestros datos. De forma muy simple, podemos activar las características mediante las cuales podemos saber no solo cuantas veces ha cambiado un dato de valor, sino incluso todos los cambios por los que ha pasado e incluso (esto ya con algo de trabajo por nuestra parte) quién lo ha realizado.

¿te gustaría saber si alguien trata de obtener información sobre tu nómina? Puedes activar otra característica llamada Auditing, por la cual puedes incluso saber quien está lanzando una select (con su query) que implique lectura de alguna tabla.

  • TVP

Las siglas TVP (Table Value Parameters) hacen referencia ni mas ni menos que a la posibilidad de que nuestras aplicaciones puedan enviar tablas como parámetros de entrada de procedimientos almacenados y funciones। Algo que a priori quizás no le veas mucho sentido si no te paras a pensarlo, pero que supone un aumento de rendimiento brutal porque simplemente, SQL Server trabaja mejor con conjuntos, por lo que es exageradamente mas eficiente procesando una actualización de 100 filas, que 100 actualizaciones de una fila।

Este último realmente requiere que las aplicaciones cliente le saquen provecho, pero no he podido dejarlo pasar en este post porque me encanta ;)

Como se ha podido ver, existen numerosas características en SQL Server 2008 aprovechables de entrada, sin necesidad de tener que hacer un esfuerzo considerable ni mucho menos (algunas ya las obtenemos simplemente al restaurar el backup sobre 2008).

En cualquier caso, estas características no son ni mucho menos las únicas que aparecen en SQL 2008 y sino, aquí va una prueba:

image

domingo, 29 de marzo de 2009

Migración de SQL Server 2000 a 2008 y SQL Profiler

Cuando uno se plantea una migración de SQL Server, no solo se plantea analizar el propio servidor y las BBDDs, sino que debe plantearse también las aplicaciones cliente. Un argumento más para tener en cuenta en pro del uso de procedimientos almacenados es que el Sql Server Upgrade Advisor (SSUA a partir de ahora) es capaz de analizar los objetos de la BBDD y por lo tanto será capaz de detectar código “deprecated” en el mismo. Puesto que las aplicaciones cliente en ocasiones generan T-SQL ad-hoc, la aplicación SSUA nos provee de análisis de trazas de profiler capturadas. De este modo, podremos generar una traza de profiler sobre el servidor X y posteriormente pasársela al SSUA y que nos diga si realmente existen sentencias depreciadas que hayan sido originadas por nuestras aplicaciones.

Para ello, hagamos lo siguiente:

  • Abrir SQL Server Profiler 2000 (nótese que pongo 2000, no 2008 – ver final del post-)
  • Capturar una traza “Replay”. Puesto que capturar una traza replay genera una alta cantidad de información, lo primero que podemos hacer es crear una traza que contenga los eventos SQL:BatchStarting, SQL:SmtpStarting y RPC:Starting. Esta traza ocupará bastante menos que la de Replay y podremos realizar los análisis de forma previa mas rápidos.

image

  • Dejar correr la traza para capturar las consultas que llegan desde aplicaciones cliente (en nuestro caso, únicamente he lanzado una select depreciada que veremos al final).
  • Una vez capturada información durante un tiempo prudencial y representativo (1 semana?), la podemos salvar a fichero (eso en el caso de que no la hayamos scriptado, claro)

image

  • Una vez tenemos la traza de profiler a buen recaudo, procederemos a analizarla con el SSUA 2008

image

  • Nos conectamos a SQL Server 2000 (no hace falta que sea producción, podemos usar cualquier SQL Server 2000 que tengamos por ahí)

image

  • Una vez indicado el servidor, indicaremos que deseamos analizar únicamente la traza de profiler (en la versión SSUA 2005, no era posible analizar únicamente profiler sin especificar BBDD)

image

  • Una vez hecho esto, SSUA se pondrá a realizar el análisis de la traza de profiler. En este punto, la aplicación se conectará contra la instancia de SQL Server 2000 indicada y comenzará a realizar el análisis. para ello, ni mas ni menos se pone a ejecutar queries como un loco, para ver si alguna de las reglas de validación de queries depreciadas es violada (podemos activar el profiler si tenemos curiosidad y ver que tipo de información recupera).

image

image

  • Para este ejemplo, puesto que solo me interesa analizar la traza, los mensajes relativos a la instancia de SQL Server no son relevantes, por eso los obvio y me centro en únicamente el que se encuentra señalado en rojo.

image

image

Como vemos, el mensaje me indica que en el fichero de trazas se encuentra un SQL Batch concreto (el que se puede apreciar en la imagen). Se nos proporciona información relativa a como solucionarlo y cual es su problema (no se ve en la imagen, pero está detrás), aunque lo importante aquí es que hemos sido capaces de detectar correctamente una sentencia generada de forma AD-HOC por alguna de nuestras aplicaciones (ya nos preocuparemos nosotros de detectar quien ha originado la petición, viendo la traza de profiler).

IMPORTANTE: La traza de profiler ha de ser generada con la versión de SQL Profiler del motor SQL Server que deseemos migrar (SQL 2000 o 2005), puesto que optimizaciones en la estructura del fichero de trazas entre versiones de SQL Server hacen imposible su lectura en compatibilidad hacia atrás. Quiero decir, que si por error creáis la traza de profiler, desde SQL Profiler 2008, SSUA no va a ser capaz de analizarla y por algun tipo de bug no nos avisará de ello.

martes, 24 de marzo de 2009

Compresión de datos en SQL Server 2008 (II de III)

Como ya se comentó en el anterior post, en SQL Server 2008 no solo tenemos compresión de datos a nivel de backup, sino también a nivel datos con compresión de página y compresión de fila. En esta ocasión voy a hablar sobre la compresión a nivel de datos.

La idea de poder comprimir la información almacenada en la base de datos, evidentemente produce tanto un ahorro de espacio en disco como una mejora de rendimiento del servidor que trataremos mas adelante. Por otro lado, el mero hecho de poder comprimir tipos de datos antes considerados como estáticos, nos permite mitigar malas decisiones de diseño en nuestras bases de datos; pensemos por ejemplo en la típica situación de una mala elección de un tipo de datos ( char(255) ) por desconocimiento, que no se puede modificar por problemas de compatibilidad de las herramientas que las explotan.
Algo que debemos tener presente es que SQL Server garantiza que la descompresión de un dato siempre sea posible; esto quiere decir que el tamaño de una fila + sobrecarga por compresión no puede ser superior a 8060 bytes y eso lo garantizará el propio motor. Dicho de otro modo, la compresión de datos permite almacenar mas información por página, pero no por fila.
En este post no voy a hablar simplemente de lo que podemos ahorrarnos usando compresión, sino mas bien lo encamino a demostraros el por qué debemos pensarnos seriamente si nos conviene activarlo de una forma u otra en función de nuestros datos almacenados.
Además, conviene que en nuestro escenario, si tenemos volúmenes comprimidos donde almacenar la información de backups por ejemplo, las deshabilitemos y midamos el rendimiento ya que quizás ahora no sea necesario que se trate de comprimir algo que ya lo está. Para más información http://msdn.microsoft.com/en-us/library/ms190954.aspx apartado “Data Compression”

Compresión a nivel de fila

La compresión a nivel de fila se puede aplicar a:
  • Tablas almacenadas como HEAP (sin índices clustered)
  • Tablas almacenadas como índices agrupados
  • Índices no agrupados
  • Vistas indexadas
  • Tablas e índices particionados (inclusive de forma independiente cada partición)
Algo que debemos conocer es que la compresión no se activa en los índices no agrupados de forma automática. Por ello, si queremos que el índice no agrupado se encuentre comprimido deberemos especificarlo. Por otro lado, si tenemos una tabla almacenada como un HEAP comprimida y le creamos un índice agrupado, la compresión en este caso si que se conserva.
Y por si alguien está pensando en que esto tuviera que ver con la fragmentación…no es así, por lo que no se te ocurra eliminar los planes de mantenimiento de re indexación y reorganización de índices ;)
image
Imagen gráfica que representa la compresión a nivel de fila para tipo de datos int y numeric
Existe una tabla que indica a qué tipos de datos se aplica esta compresión (varchar, por si lo estás pensando, no obtiene mejoria con este tipo de compresión).
Para más información sobre datos beneficiados por compresión de fila: http://msdn.microsoft.com/en-us/library/cc280576.aspx

Compresión a nivel de página

SQL Server 2008 nos permite ir mas allá en la compresión de datos gracias a la compresión de páginas. Se trata de un paso mas en el proceso de compresión que nos permite exprimir todavía mas el ratio de compresión conseguido. Pero ojo porque no todo es oro lo que reluce en este caso ya que el coste de CPU extra para conseguirlo puede no ser justificado si lo comparamos con la compresión de datos a nivel de fila. Este nivel de compresión solo está justificado para comprimir tablas con un alto índice de repetición de datos por página que puedan aplicar la compresión de prefijos y de diccionario.
Internamente, SQL Server realiza la compresión en estas 3 fases:
  1. Compresión de fila (visto anteriormente)
  2. Compresión mediante prefijos
  3. Compresión mediante diccionario
Enseguida veremos en qué consisten los pasos 2 y 3, pero antes de nada me gustaría recalcar de nuevo que cuanta mas frecuencia de aparición, mayor eficiencia de almacenamiento y que se trata de una compresión a nivel de página por lo que únicamente cuando la página se encuentra llena, se produce compresión a nivel de página, sino únicamente se quedará comprimida mediante row compression.

Compresión mediante prefijos

Los prefijos se almacenan en un área de la página llamada anchor record y , cada columna posee su propia lista de prefijos lo cual quiere decir (y recalco) que no se expande a otras columnas. En la siguiente imagen se puede ver el paso de compresión mediante prefijos.
image
Proceso de compresión mediante prefijos

Quisiera recalcar la palabra prefijos, puesto que puede dar lugar a que pensemos que la compresión de página no funciona si no entendemos bien lo que realmente hace para conseguirla. En la demo de mas abajo entenderéis por qué digo esto.

Compresión mediante diccionario

Una vez aplicada la compresión mediante prefijos, se realiza una pasada para aplicar la compresión mediante diccionario, que reserva en la página, un diccionario donde almacenar los prefijos comunes y substituirlos por tokens. Esto es a nivel de página, por lo que cada página posee su propio diccionario y no es extensible a otras páginas.
image
Proceso de compresión mediante diccionario

Demostraciones

Vamos a ensuciarnos las manos ya, una vez vista la parte teórica. Para ello, voy a utilizar un caso que me viene al pelo para demostraros que no siempre la compresión de página es la mejor y que siempre depende de la distribución de datos que tengamos en nuestras tablas. El script de la demostración lo tenéis mas abajo, voy a exponer sus resultados de entrada para no marearos:
Partiendo de una tabla con 1.000.000 de filas cuyas columnas son de tipos de datos bigint y varchar(200) y datos:
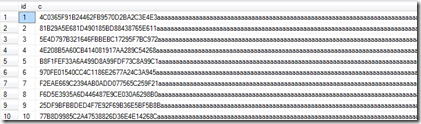
image
Vamos a ver su distribución de datos por páginas sin comprimir:
image
Si activamos la compresión a nivel de fila:
image
Si activamos la compresión a nivel de página:

image
Viendo la columna page_count, que nos indica el nº de páginas que posee el índice clústered (la tabla, vamos) nos damos cuenta que hay un descenso grande de páginas entre no tener la tabla comprimida y tenerla comprimida por fila, pero que únicamente hay una página de diferencia en el nivel hoja de aplicar compresión de página a solo aplicar compresión de fila.
Evidentemente estamos viendo que el sobrecoste del procesamiento de compresión de prefijos y de diccionario no está sirviendo prácticamente para nada (una página en un millon de filas…).
¿por qué la compresión de página no obtiene prácticamente ningún beneficio, comparado con la compresión a nivel de fila?
Pues ni mas ni menos que porque casi no hay prefijos comunes. Cuando veáis el script os daréis cuenta que la columna de tipo varchar posee un comienzo con muy poca repetición ( usa NEWID() ) y que luego nosotros rellenamos con caracteres repetidos al final. Puesto que no hay prefijos repetidos, no va a comprimir los carácteres finales y de poco nos sirve comprimir a nivel de página.
Por lo tanto, la única compresión que está realizándose es la compresión de fila de la columna id. Es más, solo está realizándose la compresión de la columna id, porque las columnas de tipo varchar no són comprimibles a nivel de fila (de nuevo os refiero a la url http://msdn.microsoft.com/en-us/library/cc280576.aspx)
¿Qué ocurre por tanto si existen prefijos comunes?
En este caso voy a hacer un poco el caso extremo en el que todas las filas tengan en una columna con un prefijo idéntico (ni que decir tiene que en mas de un sitio he visto eso y se suele llamar bug de aplicación cliente ;)
La tabla de antes, pero con prefijos comunes quedará así:
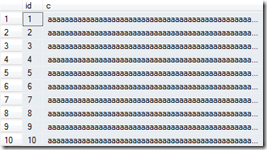
image
Sin comprimir:
image
Compresión a nivel de fila:
image
Compresión a nivel de página:
image
Nótese la grandísima diferencia en este caso de la compresión por página. Eso es debido como ya hemos comentado, a que ahora si que hay prefijos comunes y se pueden aplicar los algoritmos de compresión sobre el texto. En cualquier caso, quiero recalcar que la compresión a nivel de fila es exáctamente igual que en el caso anterior, solo ha aplicado sobre bigint, no sobre varchar.
Código con valores sin prefijos similares:
-- ECB:
--
use Northwind
go
if exists (select * from sys.tables where name = 'varchar_variable_dcha2')
    drop table dbo.varchar_variable_dcha2
go
CREATE TABLE [dbo].varchar_variable_dcha2(
  id bigint identity primary key,
    c varchar(200) NULL
)
go

declare @i int
set @i = 1
while @i<=10 -- 1.000.000 filas
begin    
    INSERT INTO dbo.varchar_variable_dcha2
    SELECT top (100000)
       replace(cast(NEWID() as varchar(100)), '-','') + REPLICATE('a', 200-32)
    FROM [Northwind].[dbo].[Orders]
    CROSS JOIN [Northwind].[dbo].[Order Details]

  print cast (@i as varchar(100))
  set @i=@i+1
end
go

select top(10) * from dbo.varchar_variable_dcha2
go
SELECT so.name, si.name, index_level, index_type_desc,
    page_count, record_count,
    avg_fragmentation_in_percent, avg_page_space_used_in_percent
FROM
sys.objects so
join sys.indexes si
on so.object_id = si.object_id
join sys.dm_db_index_physical_stats (
    db_id (),
    object_id('dbo.varchar_variable_dcha2'),
    NULL, NULL, 'DETAILED') v
on v.object_id = si.object_id
and v.index_id = si.index_id
order by index_level
go
   
ALTER TABLE dbo.varchar_variable_dcha2
REBUILD WITH (DATA_COMPRESSION = ROW);
go

SELECT so.name, si.name, index_level, index_type_desc,
    page_count, record_count,
    avg_fragmentation_in_percent, avg_page_space_used_in_percent
FROM
sys.objects so
join sys.indexes si
on so.object_id = si.object_id
join sys.dm_db_index_physical_stats (
    db_id (),
    object_id('dbo.varchar_variable_dcha2'),
    NULL, NULL, 'DETAILED') v
on v.object_id = si.object_id
and v.index_id = si.index_id
order by index_level
go

ALTER TABLE dbo.varchar_variable_dcha2
REBUILD WITH (DATA_COMPRESSION = PAGE);
go
SELECT so.name, si.name, index_level, index_type_desc,
    page_count, record_count,
    avg_fragmentation_in_percent, avg_page_space_used_in_percent
FROM
sys.objects so
join sys.indexes si
on so.object_id = si.object_id
join sys.dm_db_index_physical_stats (
    db_id (),
    object_id('dbo.varchar_variable_dcha2'),
    NULL, NULL, 'DETAILED') v
on v.object_id = si.object_id
and v.index_id = si.index_id
order by index_level
go


Código con valores de prefijos similares:


-- ECB:
--
use Northwind
go
if exists (select * from sys.tables where name = 'varchar_variable_dcha2')
    drop table dbo.varchar_variable_dcha2
go
CREATE TABLE [dbo].varchar_variable_dcha2(
  id bigint identity primary key,
    c varchar(200) NULL
)
go

declare @i int
set @i = 1
while @i<=10 -- 1.000.000 filas
begin    
    INSERT INTO dbo.varchar_variable_dcha2
    SELECT top (100000)
        REPLICATE('a', 200-32)
    FROM [Northwind].[dbo].[Orders]
    CROSS JOIN [Northwind].[dbo].[Order Details]

  print cast (@i as varchar(100))
  set @i=@i+1
end
go

select top(10) * from dbo.varchar_variable_dcha2
go
SELECT so.name, si.name, index_level, index_type_desc,
    page_count, record_count,
    avg_fragmentation_in_percent, avg_page_space_used_in_percent
FROM
sys.objects so
join sys.indexes si
on so.object_id = si.object_id
join sys.dm_db_index_physical_stats (
    db_id (),
    object_id('dbo.varchar_variable_dcha2'),
    NULL, NULL, 'DETAILED') v
on v.object_id = si.object_id
and v.index_id = si.index_id
order by index_level
go
   
ALTER TABLE dbo.varchar_variable_dcha2
REBUILD WITH (DATA_COMPRESSION = ROW);
go

SELECT so.name, si.name, index_level, index_type_desc,
    page_count, record_count,
    avg_fragmentation_in_percent, avg_page_space_used_in_percent
FROM
sys.objects so
join sys.indexes si
on so.object_id = si.object_id
join sys.dm_db_index_physical_stats (
    db_id (),
    object_id('dbo.varchar_variable_dcha2'),
    NULL, NULL, 'DETAILED') v
on v.object_id = si.object_id
and v.index_id = si.index_id
order by index_level
go

ALTER TABLE dbo.varchar_variable_dcha2
REBUILD WITH (DATA_COMPRESSION = PAGE);
go
SELECT so.name, si.name, index_level, index_type_desc,
    page_count, record_count,
    avg_fragmentation_in_percent, avg_page_space_used_in_percent
FROM
sys.objects so
join sys.indexes si
on so.object_id = si.object_id
join sys.dm_db_index_physical_stats (
    db_id (),
    object_id('dbo.varchar_variable_dcha2'),
    NULL, NULL, 'DETAILED') v
on v.object_id = si.object_id
and v.index_id = si.index_id
order by index_level
go


Resumen

La compresión de datos a nivel de fila no afecta a los siguientes tipos de datos:
  • Varchar,nvarchar,image,text,ntext
  • XML, FILESTREAM, varbinary y sql_variant
  • Date, time (ya extremadamente compactos)
El beneficio se obtiene por tanto en otros tipos de datos:
  • datetime, datetime2, datetimeoffset: ahorra 2 bytes si no almacena segundos
  • char: solo ocupa lo necesario (como varchar)
  • int, bigint,float, real,…: solo usa lo necesario
  • binary: no almacena los ceros que puede evitar
  • …
Además, en todos los tipos de datos, NULL y 0 no ocupan ningún byte
<><><><> <><><><> <><><><>
image
Por último y no menos importante, la compresión de datos solo implica tareas administrativas de SQL Server, nuestras aplicaciones son completamente agnósticas a nuestros cambios ;)